先说一个老有人误会的事儿。很多人想找一款"不用联网的AI工具",以为只要在电脑里装个大模型、把网线一拔,就能现场读表、现场写代码、现场出报告。试过才知道,根本不是那么回事。今天这篇就把"不联网做表"到底怎么落地讲透,顺便点破一个特别容易被混在一起的关键点——跑数理表"断网也能干",和生成报告"必须联网",这是两个功能,别当成一回事。先看为什么"本地塞大模型"这条路基本走不通真不联网做报表,最常踩的坑,是把希望全押在"本地大模型"上。可现实是,本地能塞下、能跑得动的,往往都是32B 以下的小模型。 7B、14B 这种参数量,写个简单的匹配、求和还凑合;一旦碰多表合并、条件统计、跨表关联、异常值清洗,它就明显顶不住了——会一本正经地给你编一个不存在的字段,或者悄悄把统计口径改掉,你还得逐行去对,纠错的时间比手工还长。就算你狠下心上了高配服务器跑更大的模型,那块显卡、那几十G显存的开销,也不是一般团队愿意一直扛着的。 所以第一条建议很直接:别指望 32B 以下的小模型去干报表处理这活。 换个思路:让"脚本"来扛报表的体力活那没有高配服务器的团队,到底怎么在"不用/少用联网"的情况下做表?答案是换条路——让脚本而不是大模型来扛脏活累活。 做法就两步:联网的时候,用结构对齐的模拟数据,把报表要用的清洗、统计、透视脚本,反复写到能稳定出正确结果为止;断网的时候,用这条定稿的脚本,去跑真实数据。模拟数据负责"保证脚本是对的",真实数据全程在本机跑,不经过任何第三方云服务。等于把"编脚本"这个高智力的环节放在联网时解决,把"跑数据"这个重复的体力活放到断网环境下解决。
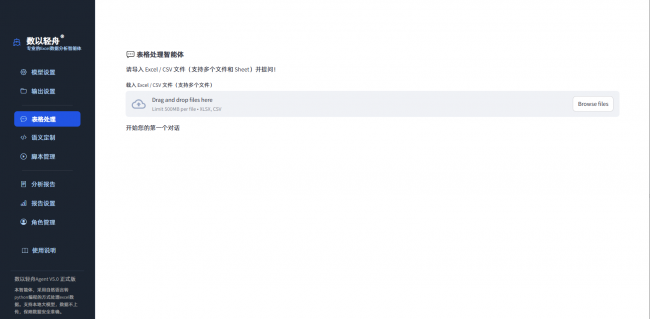
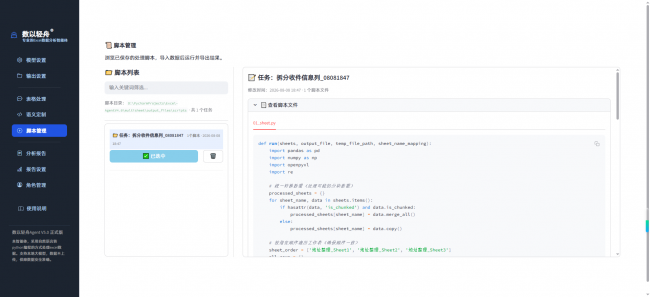
报表清洗、合并、透视等,可交给本地脚本处理 数以轻舟把这两件事拆成了两个功能这里就说到数以轻舟了——它的特别之处在于,把"报表处理"和"报告生成"明确拆成两个功能,各干各的,这也正好对应上面说的"断网跑表"和"联网出报告"。 第一个功能是报表处理。清洗、合并、透视、统计这些动作,交给脚本在本地跑;脚本写好后可以反复复用,下个月、下季度换一批数据,直接再跑一次就行,断网也没关系,还能省下大量重复调用模型的 token。这一步,本质上是"数据在自己的机器上被处理",网络只是用来把脚本调对,真正执行时可以离线。
报表脚本沉淀后可反复复用,断网也能跑 第二个功能是报告生成。把处理好的结果,整理成一份可编辑的 Word / PPT 报告。这个环节必须联网——要调用大模型来组织结构、润色表述、排版呈现,本地靠脚本出不了这种"人话报告"。所以别再指望"报告也能全离线",那不现实,也没必要。
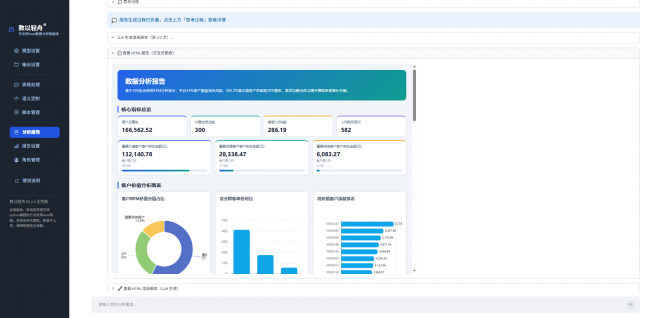
处理结果可整理成可视化看板
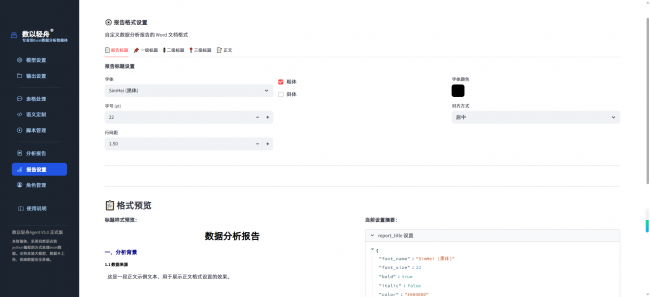
汇总结果可导出可编辑的Word/PPT报告 一句话总结两者关系:表是本地跑的,报告是联网出的。一个偏"体力",一个偏"智力",对网络的要求完全不同。你完全可以上午断网,把几百行脏数据在本机清洗完、统计好(本地脚本干);下午需要汇报了,再联网一键生成一份能改的 PPT(联网出报告)。 落地流程,大约四步把整套串起来,大概是这个节奏: 第一步,联网备脚本。用模拟数据,让它以轻舟反复生成、校正报表脚本,并沉淀成你团队的"脚本库"。 第二步,断网跑表。在断网或内网环境,加载真实数据,跑定稿的报表脚本,清洗、合并、统计一次完成。 第三步,联网出报告。需要交付时,联网调用模型,把表结果生成可编辑的 Word / PPT,直接拿去汇报。 第四步,迭代复用。表结构变了、统计口径改了,回到联网环境让脚本同步更新,再沉淀回脚本库,越用越顺。 想"真·断网,还边聊边实时改表",本地没有 32B 以上的大模型,体验必然会打折;报告环节如果强行断网,会因调不到大模型而"卡住"——这正是它为什么要联网。它最舒服的场景,是表结构稳定、报表逻辑重复、数据又敏感的那类活儿:财务对账、人事薪酬、经销商进销存、门店汇总、物流对账。这种场景,报表永远可以在断网下用本地脚本跑完,需要报告时再联网生成。如果你也正卡在"想离线处理数据、又没有高配服务器"的纠结里,我的建议很简单:别再让本地小模型的脸色决定你能不能做表了,让数以轻舟把报表脚本沉淀成你自己的资产——联网写脚本、断网跑表、联网出报告,三步各干各的。花半天摸清自家的报表体系,往后每个月的数据活儿,都能安安稳稳跑完。 文章引自:https://www.syqzai.com/blog/offline-table-local-script.html |